Một công cụ dịch cần được kiểm tra từng đoạn
Bài báo MITRA-MT của Sebastian Nehrdich và Kurt Keutzer có trong kỷ yếu WMT ghi ngày 28–29 tháng 10 năm 2026. Bài báo mô tả mô hình 9 tỷ tham số được thích nghi với các ngôn ngữ văn học Phật giáo và đánh giá 17 hướng dịch ở cấp câu; mười hướng còn được thử ở cấp đoạn. Đây là phân tích về công bố ấy, không phải khẳng định mô hình vừa ra mắt hôm nay. Khác với MITRA-lexicon, vốn tra cứu những tương ứng từ ngữ đã được ghi nhận trong văn bản, MITRA-MT tạo ra bản dịch các đoạn văn. [1] [2]
Trước hết, xác định phiên bản ngữ liệu
Bài báo mô tả MITRA-parallel v2: 1,693,730 bản ghi được căn chỉnh tự động, đại diện cho 2,338,400 cặp phân đoạn bằng tiếng Phạn, tiếng Tây Tạng và Hán văn Phật giáo. Một bản ghi có thể nối nhiều phân đoạn; đây không phải số sách hay số bản dịch đã được con người duyệt. Khi chúng tôi kiểm tra ngày 31 tháng 10, kho mã đã ghi v3 là bản hiện hành, gồm 1,690,655 bản ghi và một mô hình đã huấn luyện để kiểm tra, sửa các liên kết. Việc sửa tự động không đồng nghĩa với chuyên gia phê duyệt. Không thể đơn giản đổi tên kết quả của v2 thành bằng chứng cho chất lượng v3. [3] [4]
Còn một giới hạn về khả năng tái lập: thẻ mô hình được liên kết mô tả huấn luyện CPO, trong khi mục 4.3 của bài báo đánh giá một checkpoint GRPO. Chúng tôi chưa xác minh được sự tương ứng chính xác giữa bản có thể tải xuống và checkpoint được đánh giá. [2] [5]
Điểm cao không phải tỷ lệ truyền đạt đúng ý nghĩa
Với hướng dịch từ tiếng Phạn sang tiếng Tây Tạng, tác giả báo cáo MITRA-MT đạt 55.0 chrF, so với 33.4 của Qwen3.5-122B. chrF đo mức trùng khớp của các chuỗi ký tự với bản dịch tham chiếu: 55.0 không có nghĩa là độ chính xác ngữ nghĩa 55%. Trong phép so sánh nhỏ hơn ở Bảng 4, hai mô hình ngôn ngữ làm giám khảo lại nhìn chung ưu tiên các hệ thống thương mại. Bài báo cũng nêu rằng các liên kết v2 được phát hành chưa qua đợt kiểm tra của con người với mẫu có tính đại diện. Đây là kết quả hứa hẹn trong những phép thử cụ thể, không chứng minh khả năng diễn giải đáng tin cậy mọi đoạn văn Phật giáo. Văn bản huấn luyện đơn ngữ không được loại bỏ phần trùng với bộ đánh giá, nên hiệu quả trên văn bản hoàn toàn chưa gặp vẫn chưa chắc chắn. [2]
Bài báo, trọng số và văn bản có điều kiện khác nhau
ACL ghi giấy phép CC BY 4.0 cho bài báo, còn thẻ mô hình dịch khai báo Apache-2.0. Cả hai đều không cấp phép cho toàn bộ văn bản nguồn. README của v2 dẫn phần giấy phép về thư mục gốc; README gốc và README của v3 được kiểm tra ngày 31 tháng 10 không nêu giấy phép chung cho cả ngữ liệu. README bộ đánh giá hướng người dùng đến điều kiện của từng nguồn và ghi tài liệu Lotsawa House là CC BY-NC 4.0. Trước khi phân phối lại một tệp hoặc dùng nó để huấn luyện, cần xác nhận điều kiện áp dụng; truy cập công khai tự nó không xác lập quyền tái sử dụng. [1] [3] [4] [5] [6]
Một bài tập nhỏ trước khi tin cậy ngữ liệu lớn
Bài tập đọc chúng tôi đề xuất: chọn một đoạn ngắn được phép sử dụng và có thể đối chiếu với nguyên bản. Ghi tên tác phẩm, ấn bản, mã đoạn, phiên bản ngữ liệu và bản sửa đổi của mô hình. Đặt nguyên bản, bản dịch tham chiếu và bản nháp máy dịch cạnh nhau. Đánh dấu phủ định bị bỏ sót, tên riêng chưa chắc chắn, mệnh đề thiếu và thuật ngữ chuyên môn; câu văn trôi chảy không chứng minh rằng các yếu tố ấy đã được giữ nguyên.
Sau đó nhờ người đọc có chuyên môn xem các điểm đã đánh dấu trong ngữ cảnh, đồng thời lưu từng sửa chữa cùng lý do. Khác biệt có thể là lựa chọn dịch hợp lý chứ không phải lỗi. Bài tập tạo ra một bản kiểm tra có ghi chép cho một đoạn; nó không xác lập tỷ lệ chính xác của toàn bộ mô hình. Bản nháp chưa được kiểm tra phải tiếp tục được ghi rõ như vậy.
Phạm vi biên tập
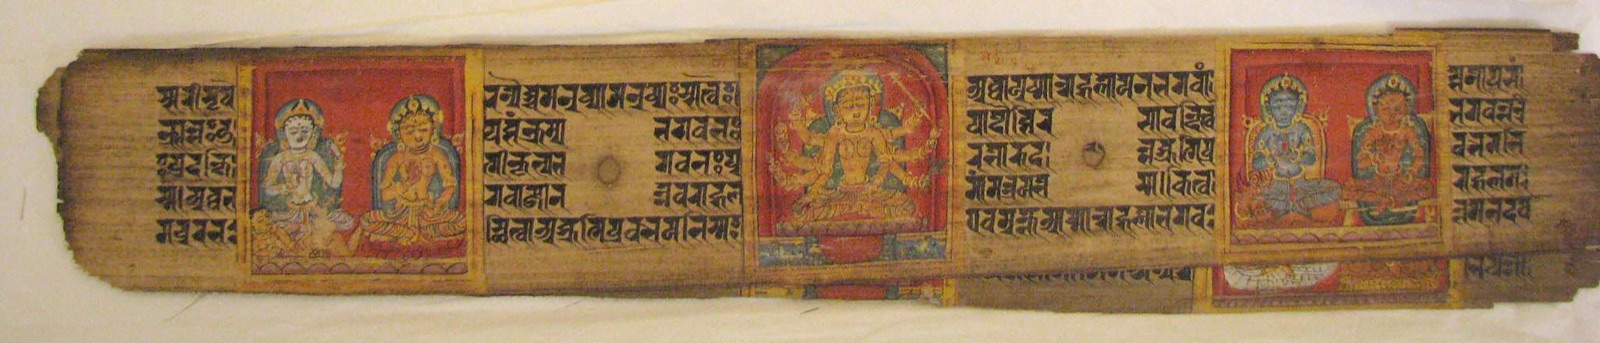
Chúng tôi đã kiểm tra bài báo và tài liệu được liên kết, nhưng không chạy lại quá trình huấn luyện hay các phép đánh giá chuẩn. Việc tìm chủ đề dùng Perplexity Deep Research; bài viết và cả 13 phiên bản ngôn ngữ được soạn, đối chiếu với hỗ trợ của AI. Việc hiệu đính ngôn ngữ bởi chuyên gia vẫn chưa hoàn tất. Ảnh bản thảo cung cấp bối cảnh lịch sử, không phải bằng chứng rằng trang được minh họa nằm trong dữ liệu huấn luyện.
Nguồn
- Nehrdich & Keutzer — MITRA-MT (WMT 2026); DOI 10.18653/2026.wmt-main.26; ACL metadata and publication licence
- MITRA-MT — full paper, sections 3–5 and 7; Table 4 (October 2026)
- MITRA-parallel — repository snapshot, v2/v3 statistics and linked documentation; checked 31 October 2026
- MITRA-parallel v3 — records and automated post-correction; checked 31 October 2026
- MITRA translation model card — CPO, separate evaluations and Apache-2.0 declaration; inspected revision 66869d9
- MITRA-MT evaluation release — source-specific attribution and reuse conditions