Преводач, който трябва да се проверява откъс по откъс
Статията за MITRA-MT на Себастиан Нердих и Курт Койцер е включена в сборника на WMT с дата 28–29 октомври 2026 г. Тя описва модел с 9 милиарда параметри, адаптиран към езиците на будистката литература, и оценка на 17 посоки на превод на равнище изречение, като десет са проверени и на равнище абзац. Това е анализ на публикацията, а не твърдение, че моделът е излязъл днес. За разлика от MITRA-lexicon, който намира засвидетелствани съответствия между думи, MITRA-MT създава преводи на откъси. [1] [2]
Първо уточнете версията на корпуса
Статията описва MITRA-parallel v2: 1,693,730 автоматично подравнени записа, представляващи 2,338,400 двойки сегменти на санскрит, тибетски и будистки китайски. Един запис може да свързва няколко сегмента; това не е брой книги или одобрени от човек преводи. При проверката ни на 31 октомври хранилището вече посочваше v3 като текуща версия, с 1,690,655 записа и обучен модел, който проверява и поправя подравняванията. Автоматичната поправка не означава одобрение от специалист. Резултатите за v2 не бива просто да се представят като доказателства за v3. [3] [4]
Има и друга граница на възпроизводимостта: картата на достъпния модел описва обучение CPO, докато раздел 4.3 на статията оценява вариант след GRPO. Не успяхме да потвърдим точно съответствие между версията за изтегляне и оценения вариант. [2] [5]
Високият резултат не е процент правилно предаден смисъл
За превод от санскрит на тибетски авторите съобщават 55.0 chrF за MITRA-MT срещу 33.4 за Qwen3.5-122B. chrF измерва съвпадението на последователности от знаци с референтни преводи: 55.0 не означава 55% смислова точност. В по-малкото сравнение в таблица 4 два езикови модела оценители предпочитат като цяло търговските системи. Статията посочва и липса на представителна човешка проверка на публикуваните подравнявания във v2. Това са обещаващи резултати в конкретни тестове, но не доказват надеждно тълкуване на всеки будистки откъс. Едноезичните обучаващи текстове не са били прочистени от припокриване с оценъчния набор, затова представянето върху напълно непознати текстове остава неустановено. [2]
Статията, теглата и текстовете имат различни условия
ACL посочва CC BY 4.0 за статията, а картата на преводаческия модел обявява Apache-2.0. Нито едното указание лицензира всички изходни текстове. README на v2 препраща за лиценза към корена на хранилището; проверените на 31 октомври основен README и README на v3 не посочват общ лиценз за корпуса. README на оценъчния набор препраща към условията на всеки първоизточник и обозначава материалите на Lotsawa House като CC BY-NC 4.0. Преди разпространение на избран файл или използването му за обучение потвърдете приложимите условия; публичният достъп сам по себе си не установява разрешение за повторна употреба. [1] [3] [4] [5] [6]
Малко упражнение преди доверие в голям корпус
Предлагаме следното упражнение: изберете кратък откъс, който имате право да използвате и можете да сверите с оригинала. Запишете произведението, изданието, идентификатора на откъса, версията на корпуса и ревизията на модела. Поставете един до друг оригинала, референтния превод и машинната чернова. Отбележете изпуснати отрицания, несигурни имена, липсващи части на изречения и специализирани термини; гладкото изложение не доказва, че те са запазени.
След това помолете квалифициран читател да прегледа отбелязаните места в контекст и запазете всяка поправка с основанието ѝ. Разликата може да е допустим преводачески избор, а не грешка. Упражнението дава документиран преглед на един откъс; то не установява точността на целия модел. Непроверените чернови трябва да останат обозначени като такива.
Обхват на редакционната работа
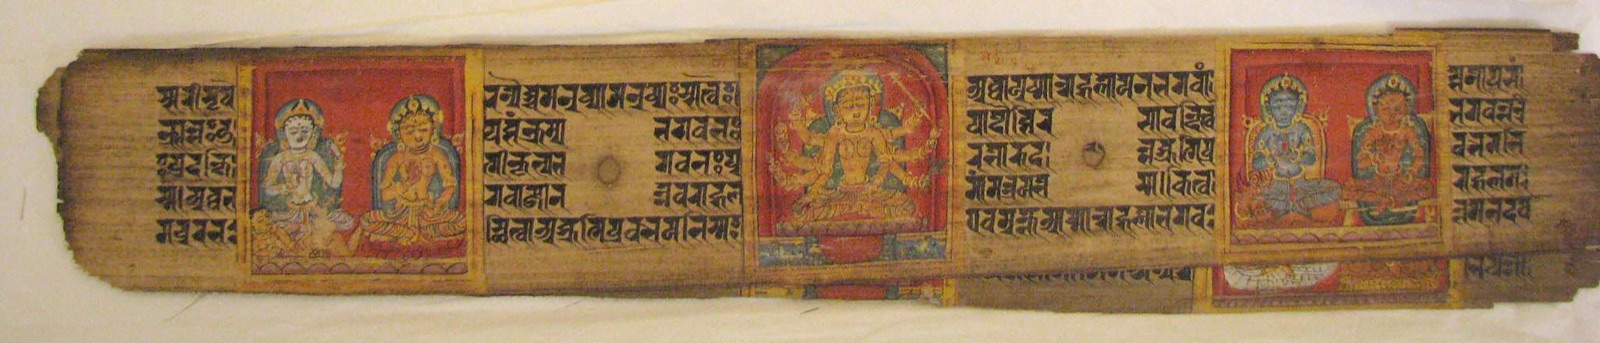
Проверихме статията и свързаната документация, но не повторихме обучението или оценъчните експерименти. За търсенето на темата използвахме Perplexity Deep Research; материалът и всичките 13 езикови версии са подготвени и съпоставени с помощта на ИИ. Езиковата проверка от специалисти предстои. Илюстрацията на ръкописа дава исторически контекст и не доказва, че изобразеният лист е бил част от обучаващите данни.
Източници
- Nehrdich & Keutzer — MITRA-MT (WMT 2026); DOI 10.18653/2026.wmt-main.26; ACL metadata and publication licence
- MITRA-MT — full paper, sections 3–5 and 7; Table 4 (October 2026)
- MITRA-parallel — repository snapshot, v2/v3 statistics and linked documentation; checked 31 October 2026
- MITRA-parallel v3 — records and automated post-correction; checked 31 October 2026
- MITRA translation model card — CPO, separate evaluations and Apache-2.0 declaration; inspected revision 66869d9
- MITRA-MT evaluation release — source-specific attribution and reuse conditions