逐段检验的翻译工具
Sebastian Nehrdich与Kurt Keutzer的MITRA-MT论文收录于标注2026年10月28—29日的WMT会议论文集。论文介绍了一个针对佛教文献语言适配的90亿参数模型,并评测了17个句子级翻译方向,其中10个也接受了段落级评测。本文是对该论文的分析,并非声称模型今天才发布。MITRA-lexicon检索已有文献中的词语对应关系,而MITRA-MT生成整段文本的翻译。 [1] [2]
先确认讨论的是哪个语料版本
论文描述的是MITRA-parallel v2:1,693,730条自动对齐记录,包含梵文、藏文和佛教汉文之间的2,338,400对文本片段。一条记录可能关联多个片段;这些数字不是书籍数量,也不是经人工认可的译文数量。我们于10月31日核查时,仓库已将v3列为当前版本,含1,690,655条记录,并用训练过的模型检查和修正对齐关系。这种自动修正不等于专家认可。不能直接把v2的评测结果改称为v3质量的证据。 [3] [4]
可复现性还有一个限制:链接的模型卡描述CPO训练,而论文第4.3节评测的是GRPO检查点。我们未能确认可下载的修订版本与论文评测的检查点完全对应。 [2] [5]
高分不等于正确传达意义的百分比
在梵文译藏文任务中,作者报告MITRA-MT的chrF为55.0,Qwen3.5-122B为33.4。chrF衡量与参考译文之间的字符序列重合程度:55.0不表示语义准确率为55%。在表4规模较小的比较中,两种担任评审的语言模型总体上反而更偏好商业系统。论文还说明,发布的v2对齐结果没有经过具有代表性的人工审核。这些是特定测试下有潜力的结果,并不能证明系统能可靠解释每一段佛典。 单语训练文本未针对评测集进行去重排除,因此模型在完全未见过的文本上的表现仍不确定。 [2]
论文、模型权重与文本适用不同条件
ACL将论文列为CC BY 4.0许可,翻译模型卡则声明Apache-2.0。这两项声明都不意味着所有底层文本因此获得同样授权。v2的README将许可问题指向仓库根目录;10月31日核查的根目录README和v3 README均未列明整个语料库的统一许可。评测集README要求使用者遵守各原始来源的条件,并将Lotsawa House材料标为CC BY-NC 4.0。在再分发选定文件或将其用于训练前,应确认适用条件;公开可访问本身不能确定再利用权限。 [1] [3] [4] [5] [6]
信任大型语料库之前,先做一个小练习
我们建议这样阅读:选择一段获准使用、且能与原文核对的短文。记录作品、版本、段落标识、语料版本及模型修订版本。将原文、参考译文和机器草稿并排放置。标出遗漏的否定词、存疑的名称、缺失的分句和专业术语;表达流畅并不能证明这些内容都被完整保留。
然后请具备相应资质的读者结合上下文检查标记处,保留修改及其理由。差异可能是合理的翻译选择,而不一定是错误。这个练习得到的是一段文本的可追溯审阅,不能据此确定整个模型的准确率。未经审核的草稿应保留相应标注。
编辑工作的范围
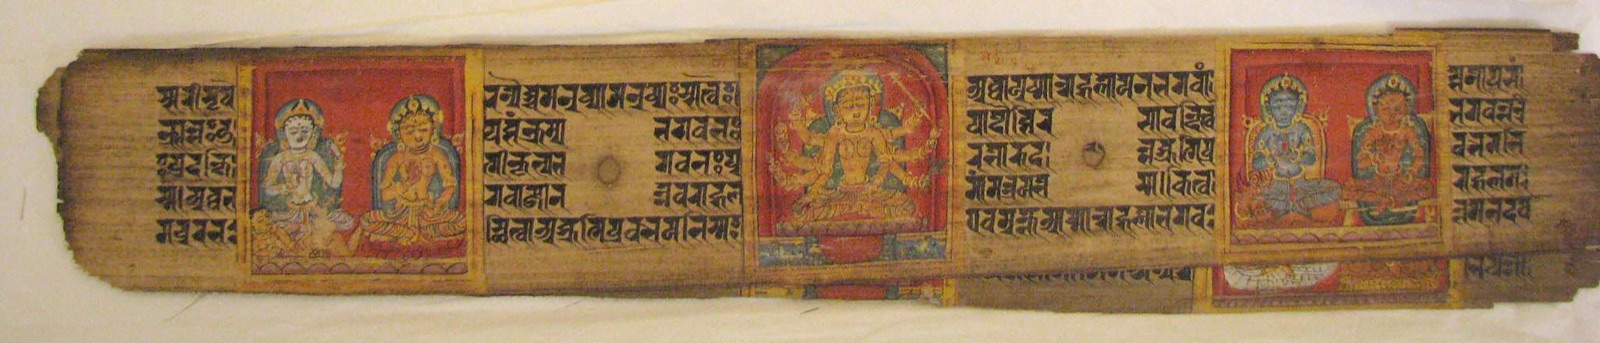
我们核查了论文及其链接的文档,但没有重新训练模型或复现基准测试。选题研究使用了Perplexity Deep Research;文章及全部13种语言版本借助人工智能起草并进行对照。专业语言审校尚未完成。手稿插图用于提供历史背景,不代表图中的书叶曾进入训练数据。
来源
- Nehrdich & Keutzer — MITRA-MT (WMT 2026); DOI 10.18653/2026.wmt-main.26; ACL metadata and publication licence
- MITRA-MT — full paper, sections 3–5 and 7; Table 4 (October 2026)
- MITRA-parallel — repository snapshot, v2/v3 statistics and linked documentation; checked 31 October 2026
- MITRA-parallel v3 — records and automated post-correction; checked 31 October 2026
- MITRA translation model card — CPO, separate evaluations and Apache-2.0 declaration; inspected revision 66869d9
- MITRA-MT evaluation release — source-specific attribution and reuse conditions